
 智联海
同一模型两次构建性能不同,怎样保留推理优化证据
TensorRT性能优化资料讨论计时缓存与构建优化,并强调先建立测量基线。以下将构建耗时、生成产物和推理行为分别记录,避免缓存命中成为唯一的优化成功标准。
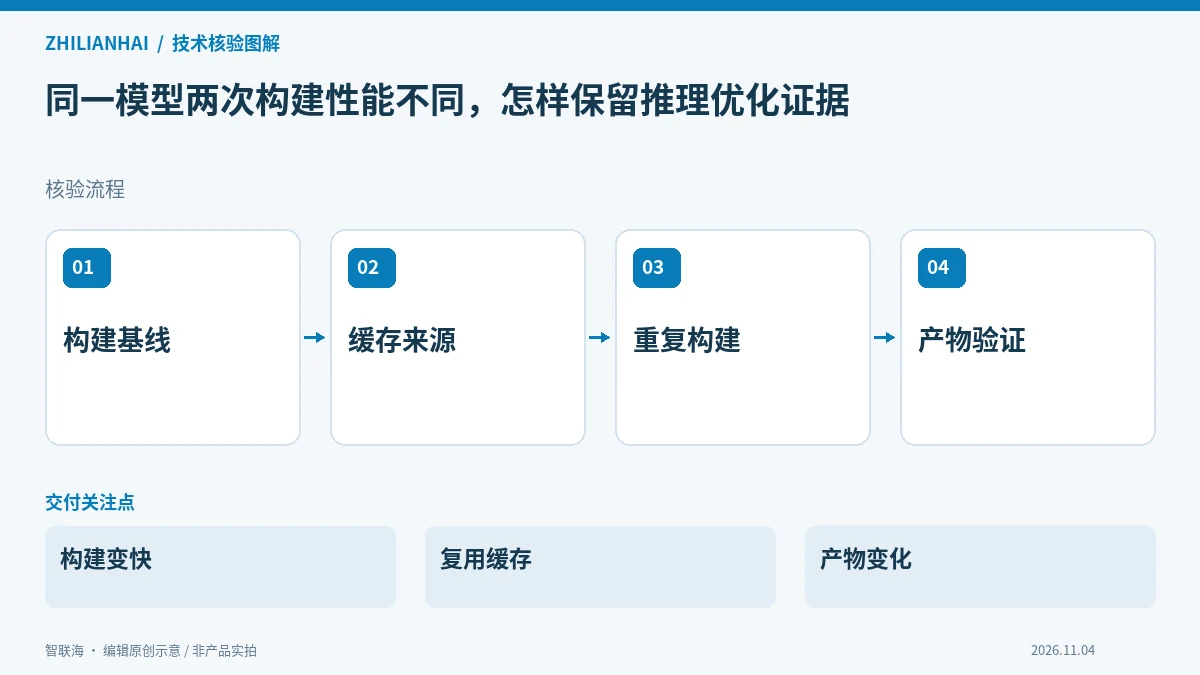
明确优化的是构建阶段
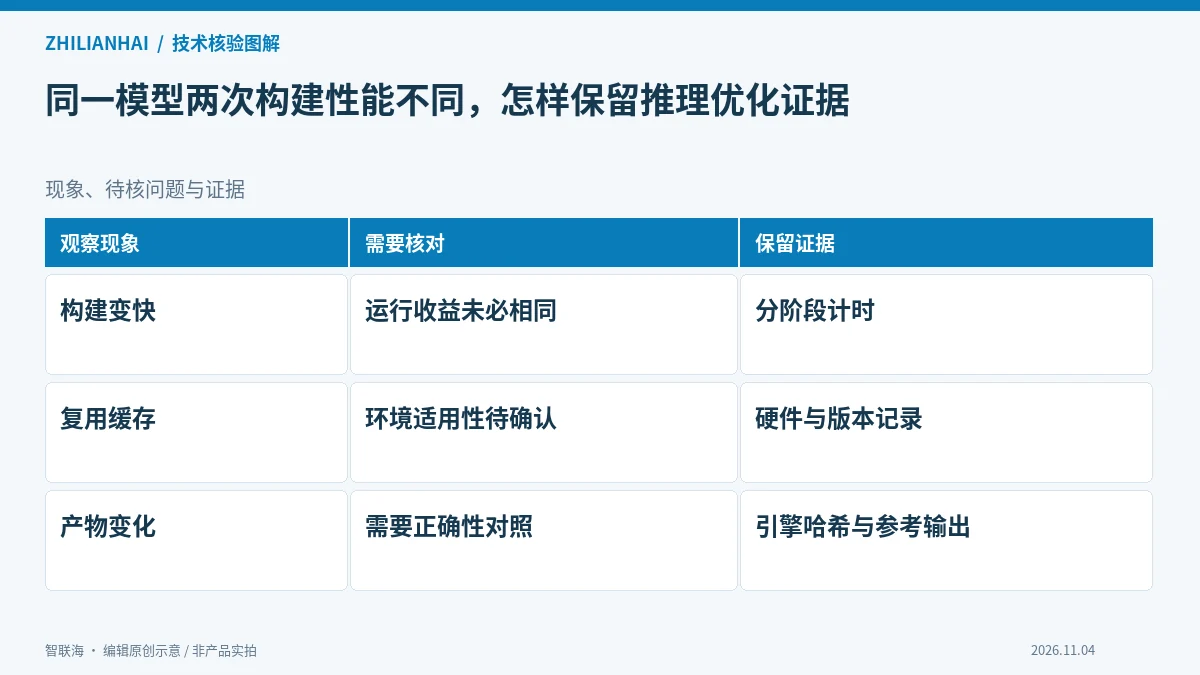
分别测量解析、构建和推理,说明计时缓存参与哪一步。构建更快不自动意味着推理更快,也不能仅用总脚本运行时间推断每个阶段获得了多少收益。
先记录交付设备、软件与配置版本,再确认本节所述能力是否由该组合实际提供。把未支持、未启用和未验证分别记录;其他机型的演示不能代替当前交付对象的证据。
记录缓存来源与环境
关联缓存、模型、硬件、运行库和构建配置,保留文件身份。复用条件应依当前文档核对,不要把来源未知的缓存当作通用优化包复制到不同设备。
验证时保留原始输入和判断依据,避免只交付一张成功截图。每一轮只改变已约定的变量,记录变化前后的配置与结果;未覆盖的边界条件需要明确列出,不能自动计入通过范围。
比较重复构建的结果
用相同输入与已记录环境观察有无可用缓存的构建时间,并核对生成引擎输出。构建产物不必只用文件名区分,保存哈希和结果样本,帮助解释重新构建后的差异。
将图中三种现象作为讨论起点,而不是对现场故障的预先诊断。先核对记录是否完整、单位和身份是否一致,再决定需要补充哪项观察。若证据不足,应保留待确认结论,而不是用经验值填补缺失字段。
控制构建期间的外部干扰
记录构建时设备负载与资源条件,避免在两次不同竞争状态下直接比较时间。若生成策略或性能存在变化,先保留构建日志和设置,不要把所有差异归因于模型本身。
由现场负责人确定获准的隔离验证方式,分别记录正常、异常和恢复阶段。验证重点是系统如何识别和解释不可信输入,不应为了取得异常样本而让实际生产设备执行未经评估的动作。
交付重建与清缓存策略
说明何时保留、更新或不使用缓存,并保存可运行基线。版本或硬件变化后重新验证构建与输出,接收方应能在没有旧缓存时完成可解释的重建,而不是依赖唯一文件。
交付时附上配置、样本、结果表和未决问题,并约定后续变更的复核责任。接收方应能随机挑选一条结论,回到对应输入与判断过程;若做不到,这份报告仍需要补充可追溯资料。